수작업 체크리스트
가장 빨리 도입할 수 있지만, 회차가 늘어날수록 사람이 처리할 물량 자체가 계속 늘어나는 구조라 근본적인 해결이 아니었습니다.
Case Study · 01
KDT 슬랙 운영 자동화 봇은 한 번 만들고 끝난 프로젝트가 아니라, 실제 운영 중 발견된 문제들을 하나씩 근본 원인까지 추적해 고쳐온 과정입니다. 그 과정을 그대로 정리했습니다.
Problem
KDT(K-디지털 트레이닝) 과정은 회차마다 새로 시작합니다. 회차가 열릴 때마다 슬랙 채널을 여러 개 만들고, 훈련생·교강사를 초대하고, 공지와 캔버스 문서를 세팅하는 일이 매번 반복됐습니다. 과정 수가 늘어날수록(연간 31개 과정) 이 반복 작업에 쓰는 시간과, 사람이 손으로 하다 생기는 누락(초대 빠짐, 문구 오기재)이 함께 늘어났습니다.
단순히 "빠르게 처리하는 도구"만으로는 부족하다고 판단했습니다. 회차는 계속 새로 열리고, 운영 중간에 채널 구성이나 안내 문구가 바뀌는 일도 잦았기 때문에, 한 번 실행하고 끝나는 스크립트가 아니라 여러 번 다시 실행해도 안전하게 동작하는 도구가 필요했습니다.
Design & Validate
바로 코드부터 짜지 않고, PRD를 먼저 작성했습니다. 문제 정의, 입력값 스펙, 성공 기준(무엇이 되면 성공인지), 예상 리스크와 대응, 그리고 아직 확정하지 못한 미결 질문까지 문서로 정리해 이해관계자와 같은 그림을 보고 시작했습니다.
실제 세팅 엔진을 붙이기 전에는 정적 프로토타입을 먼저 만들어, 입력값을 넣으면 어떤 채널·공지·검수 항목이 생성되는지 화면으로 보여주고 PM·운영자의 확인을 받았습니다. "일단 만들고 고치자"가 아니라 "먼저 합의하고 만들자"가 이 프로젝트의 방식이었습니다.
Approach
수작업, 스프레드시트 매크로, 서버리스 자동화 세 가지를 두고 비교했고, Slack 플랫폼의 권한 제약에 맞춰 실행 방식을 나눴습니다.
가장 빨리 도입할 수 있지만, 회차가 늘어날수록 사람이 처리할 물량 자체가 계속 늘어나는 구조라 근본적인 해결이 아니었습니다.
친숙하지만 슬랙 API 호출, 인증, 재실행 시 상태 관리(이미 만든 채널을 다시 만들지 않기)를 안정적으로 다루기 어려웠습니다.
실행마다 인증을 강제할 수 있고, 상태(이미 세팅된 채널·문서)를 KV에 저장해 재실행 시 "무엇이 이미 됐고 무엇이 안 됐는지" 판단할 수 있는 구조를 만들 수 있었습니다. 이 판단 로직이 이후 안정성의 핵심이 됐습니다.
Slack은 상위 플랜(Enterprise)에서만 워크스페이스를 API로 자동 생성할 수 있고, 일반 워크스페이스에는 그 권한이 없습니다. 그래서 "권한이 있으면 워크스페이스 생성까지 자동", "없으면 워크스페이스는 수동으로 만든 뒤 그 안의 세팅을 전부 자동"으로 두 모드로 분기해, 플랫폼 한계 안에서 자동화 가능한 범위를 최대로 끌어올렸습니다.
Build & Iterate
처음 만든 버전은 이상적인 상황만 가정했습니다. 실제 운영에 투입하면서 예상 못 한 실패가 여러 번 있었고, 매번 증상만 고치지 않고 원인을 끝까지 추적했습니다.
증상 → 원인 → 조치
파일이 많은 회차에서 실행이 중간에 멈췄습니다. 추적해보니 파일마다 매번 처음부터 내용을 다시 계산(base64/해시 변환)하느라 연산량이 한도를 넘어 서버가 강제 종료되는 것이 원인이었습니다. 캐시를 도입해 이미 계산한 내용은 재사용하도록 바꾸고, 한 번에 처리하는 작업량도 줄여 안정적으로 끝까지 실행되도록 만들었습니다.
증상 → 원인 → 조치
채널이 실수로 삭제된 뒤 다시 실행해도 복구가 안 되는 경우가 있었습니다. 원인은 "이미 만들어졌다"는 기록만 캐시에 남아 있고, 그 채널이 실제로 살아있는지는 확인하지 않는 구조였기 때문입니다. 실행할 때마다 실제 생존 여부를 확인한 뒤 없으면 다시 만들도록 로직을 고쳤습니다.
증상 → 원인 → 조치
안내 문구를 수정한 뒤 재실행해도 기존 채널의 공지·캔버스 문서는 그대로였습니다. "한 번 만든 건 다시 안 건드린다"는 원래 설계 때문이었는데, 문구가 자주 바뀌는 운영 특성과 맞지 않았습니다. 내용에 변경이 있는지 비교한 뒤, 바뀐 부분만 제자리에서 고쳐 쓰도록 바꿨습니다.
증상 → 원인 → 조치
기능이 안정된 뒤, 보안 관점에서 다시 점검했습니다. 실행 API에 인증이 없어도 호출이 가능했던 지점, 허용되지 않은 출처의 요청을 막지 못하는 지점, 서버가 내부망 주소로 요청을 보내도록 유도될 수 있는 지점을 찾아 각각 실행키 인증, 허용 출처 제한, 요청 대상 검증으로 막았습니다.
Screens
실명·소속·내부 URL 등 민감한 정보는 가리고 올렸습니다.
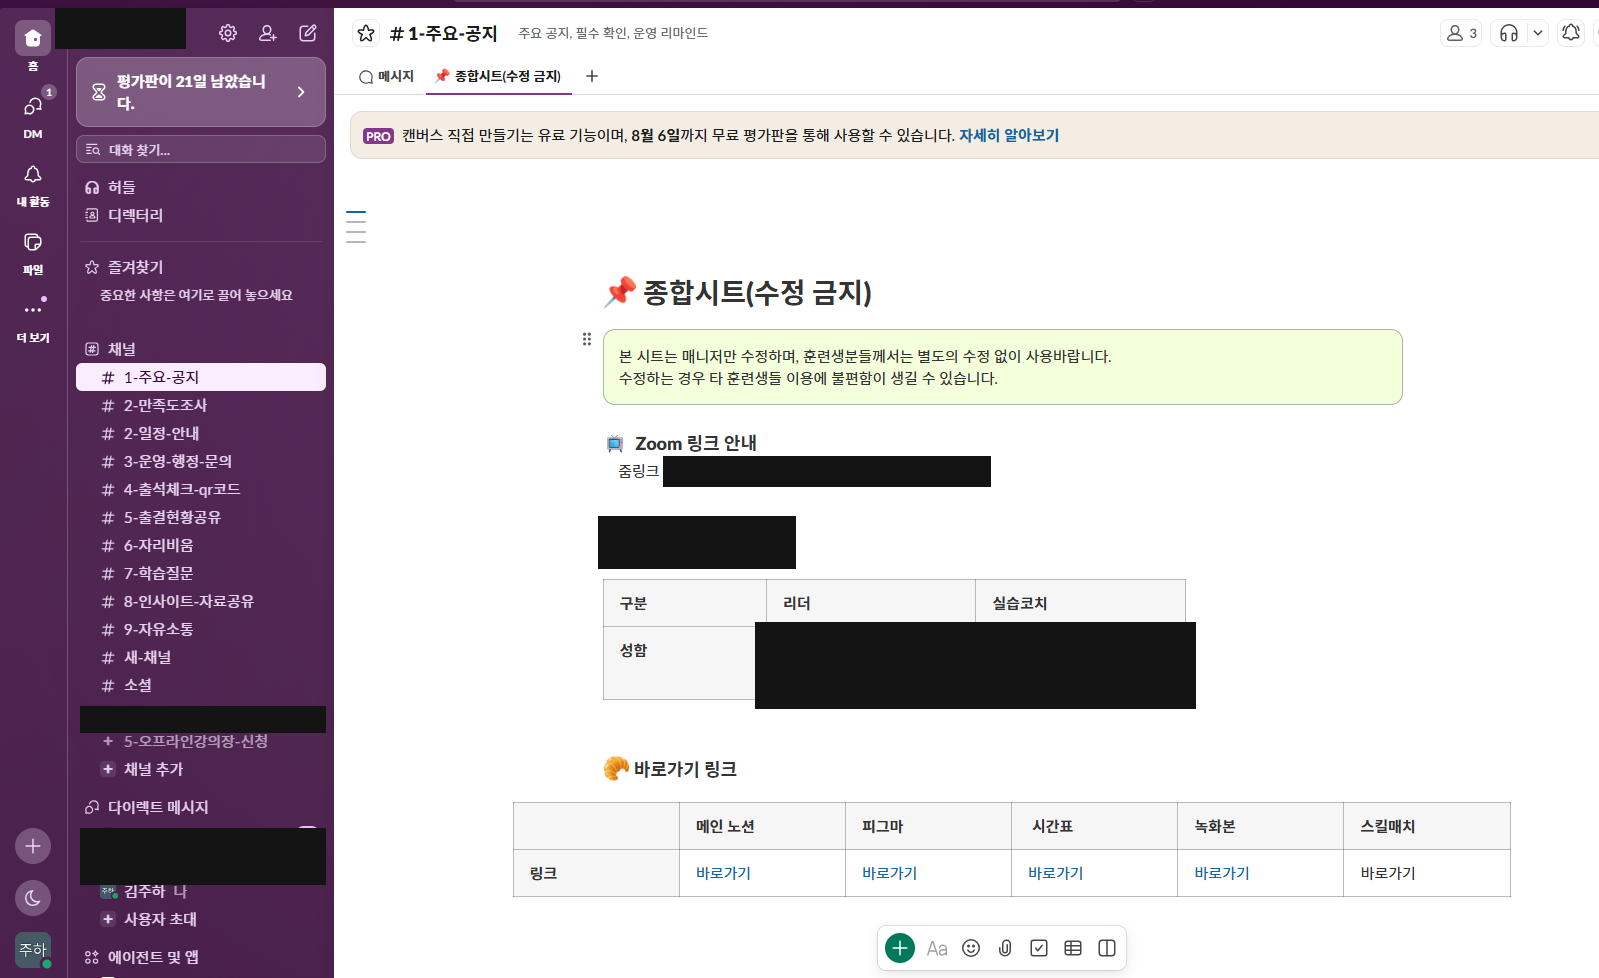
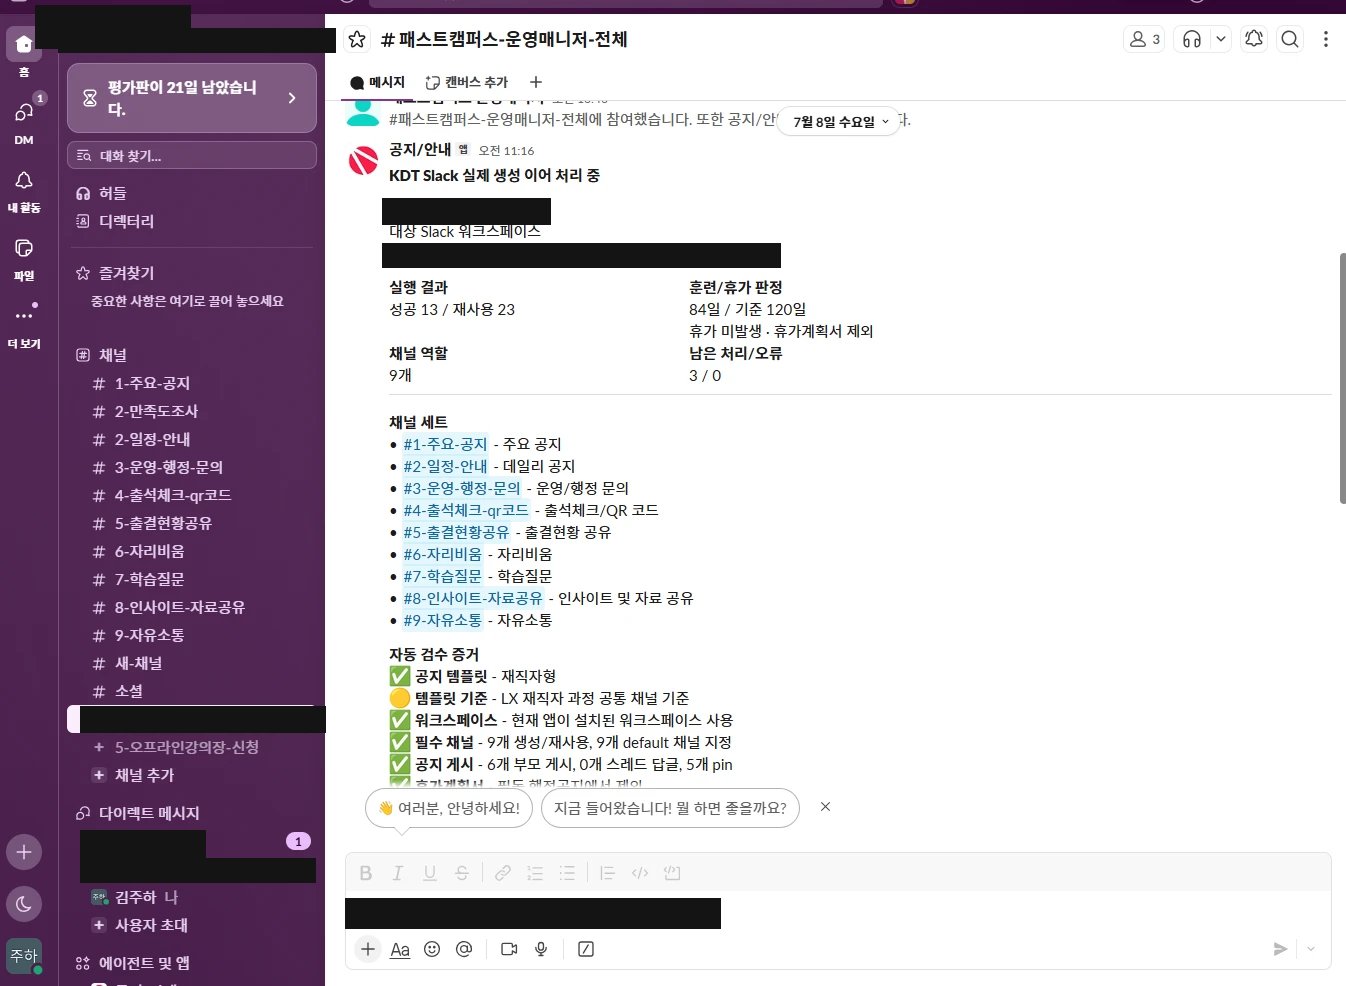
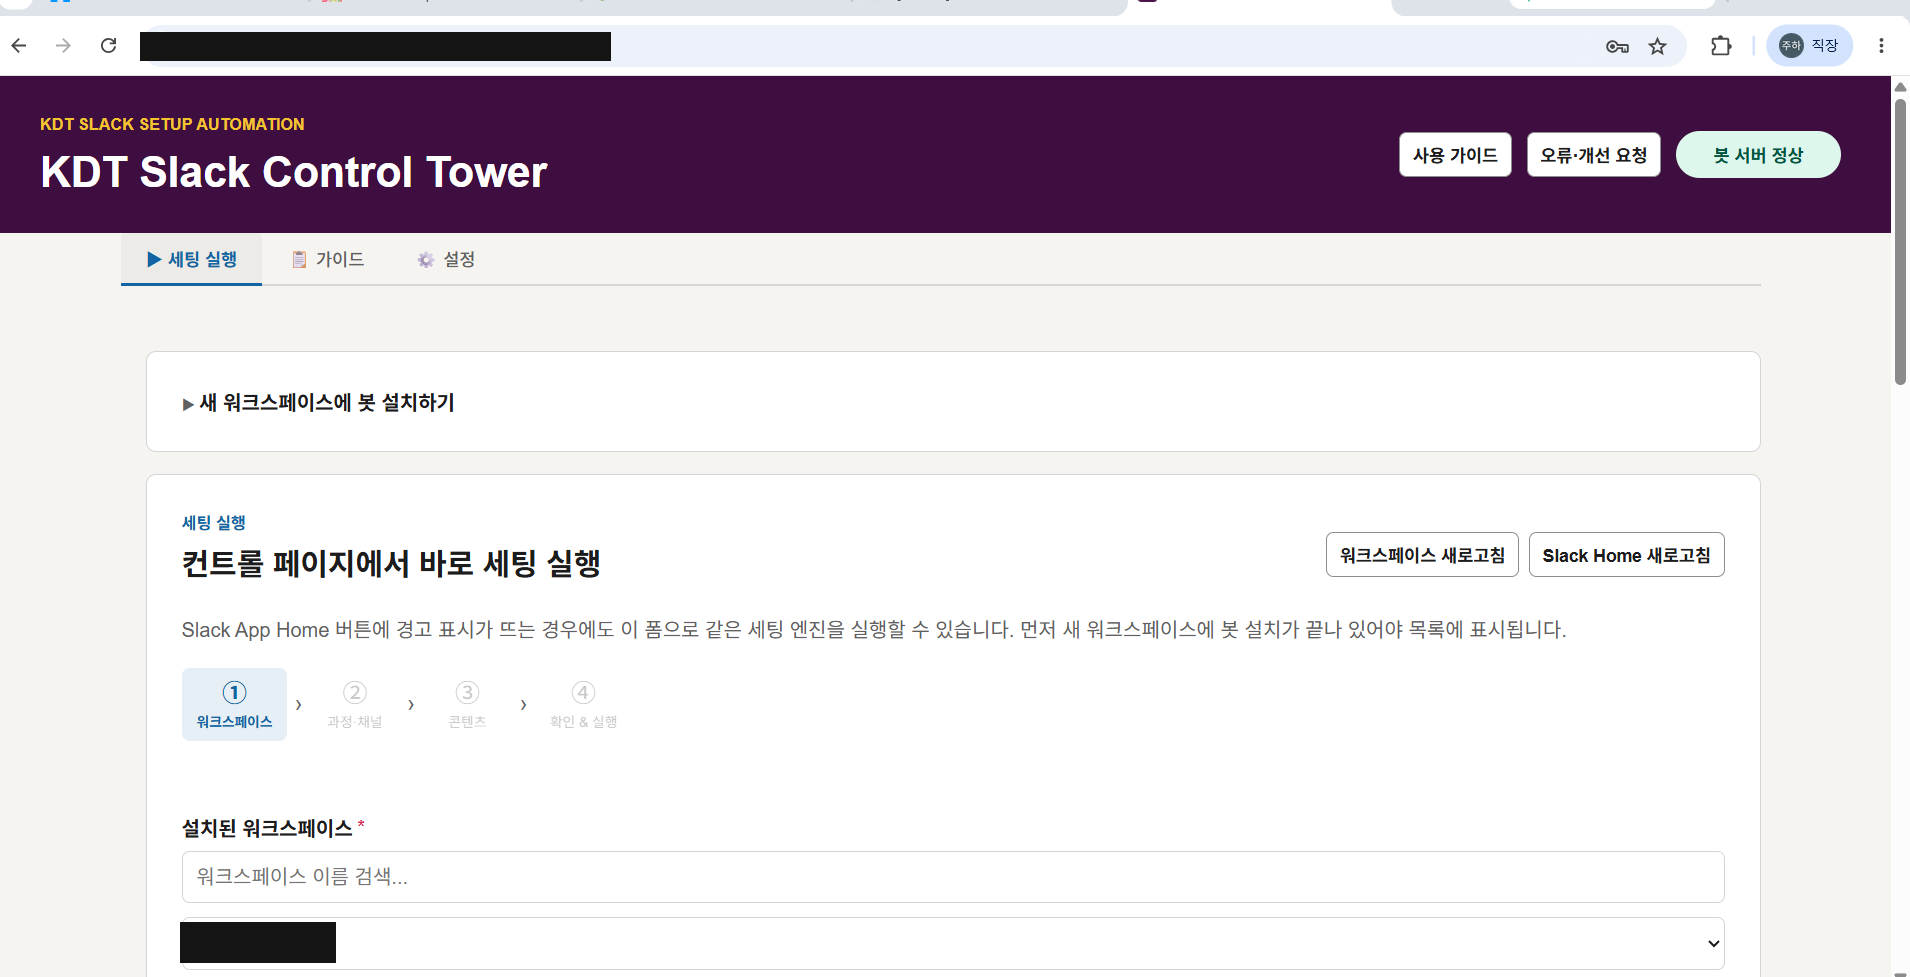
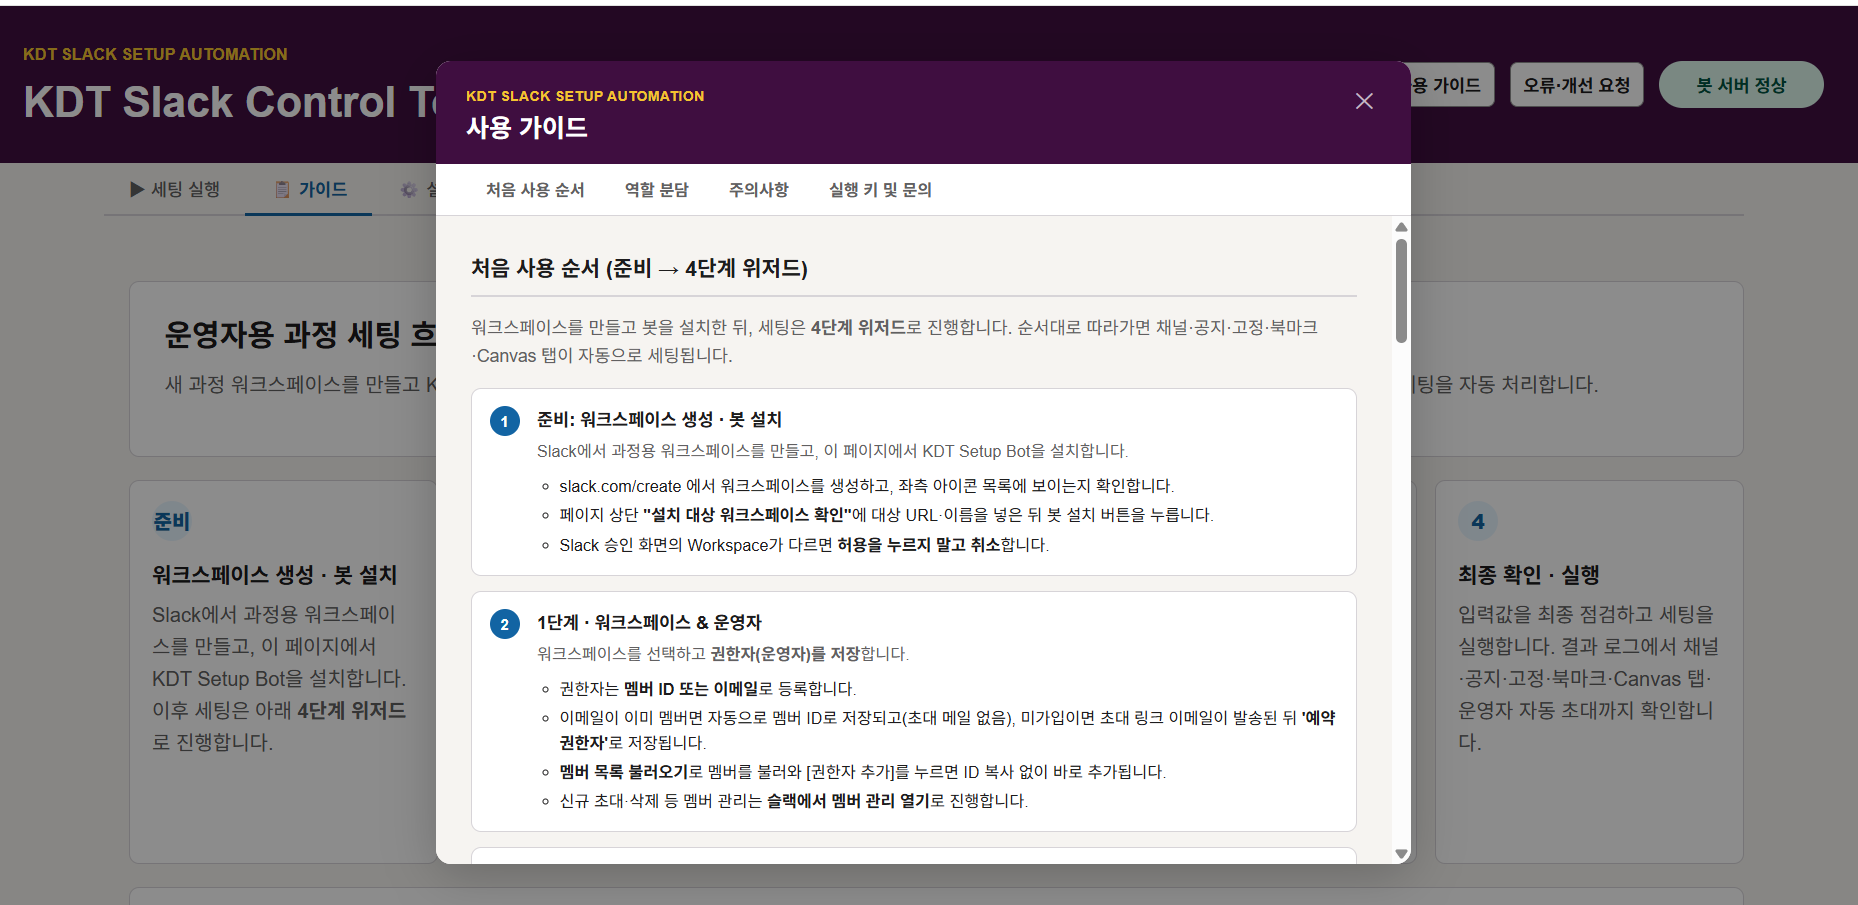
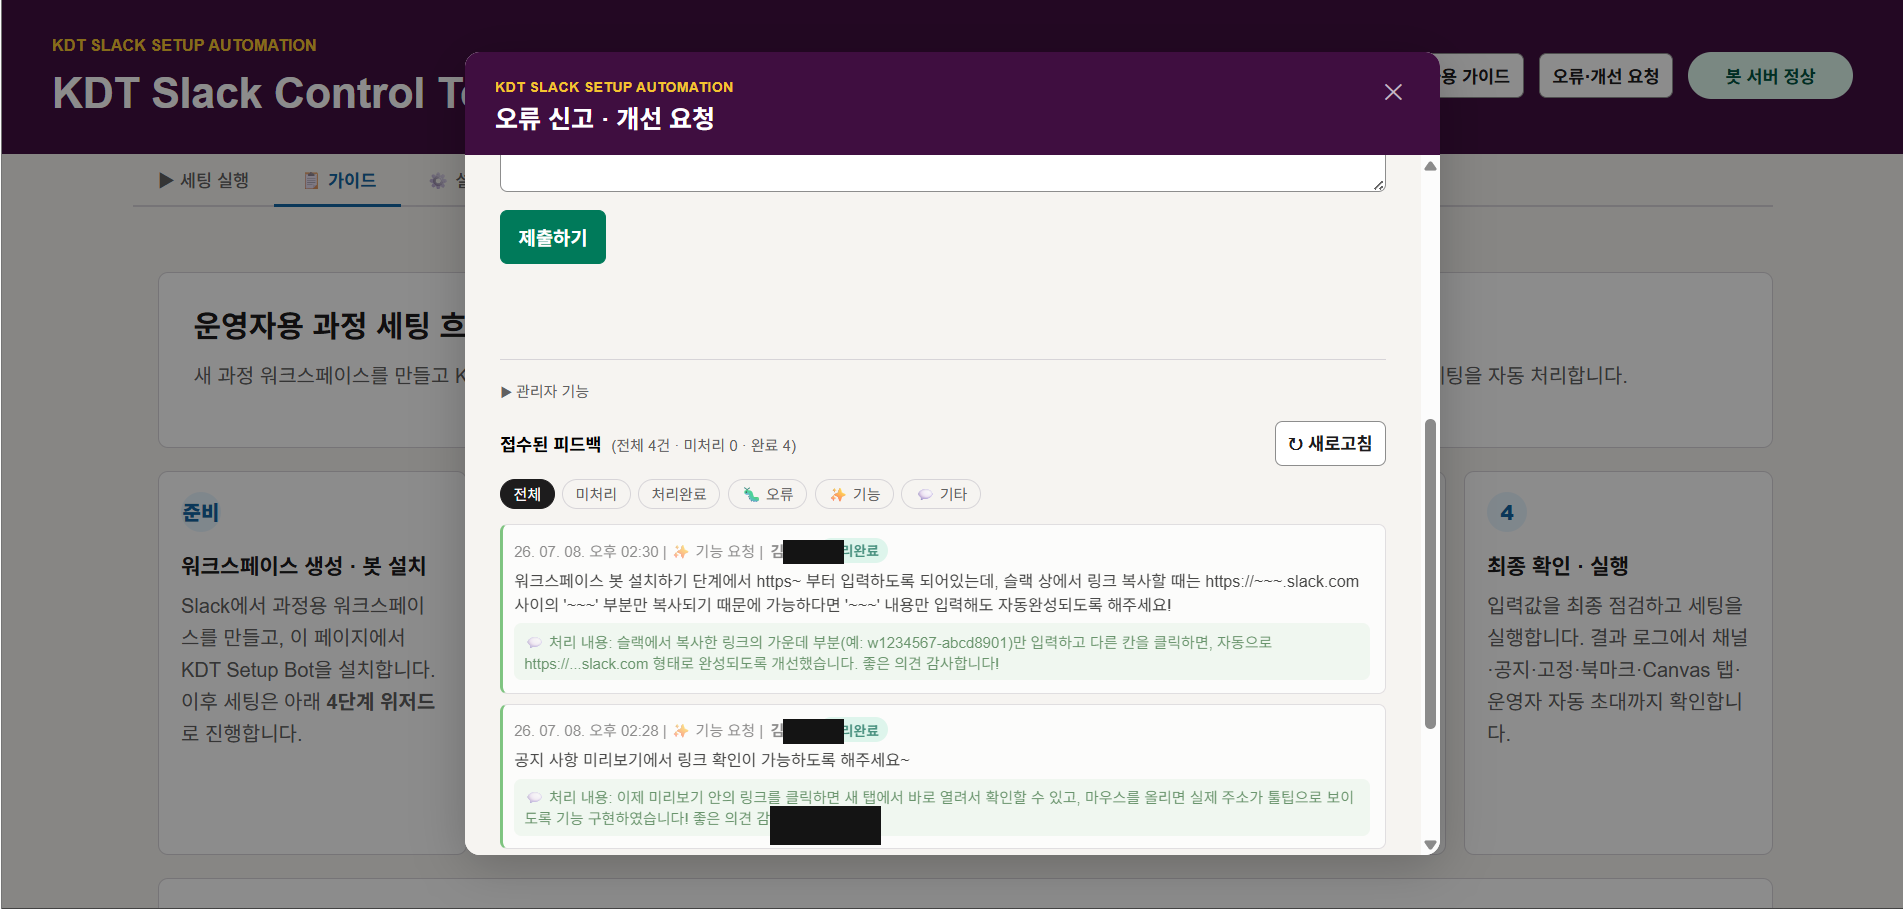
사용 가이드와 오류·개선 요청 창구를 함께 구축해, 저 혼자만 쓰는 도구가 아니라 전사에서 사용하고 피드백을 반영해 계속 발전시키는 시스템으로 운영하고 있습니다.
Result
MVP로 현업에 실제 투입되어 사용 중이며, 새로 발견되는 요청과 피드백을 계속 반영하고 있습니다. 회차가 새로 열릴 때마다, 또 운영 중 안내 문구나 구성이 바뀔 때마다 몇 번을 다시 실행해도 이미 된 것은 건드리지 않고 바뀐 것만 정확히 반영하는 구조를 갖추게 됐습니다.
배운 것 — 운영 자동화 도구는 "처음 한 번 잘 동작하는가"보다 "몇 번을 다시 실행해도 믿을 수 있는가"가 진짜 기준이라는 것입니다. 실패가 나올 때마다 증상만 덮지 않고 원인을 끝까지 따라가는 태도가, 결국 현장에서 신뢰하고 계속 쓰는 도구를 만든다고 생각합니다.